Domain wischblende.de kaufen?
Wir ziehen mit dem Projekt
wischblende.de um.
Sind Sie am Kauf der Domain
wischblende.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain wischblende.de kaufen?
Was sind effiziente Methoden zur Namensauflösung in großen Datensätzen?
Effiziente Methoden zur Namensauflösung in großen Datensätzen sind Hashing-Algorithmen, die den Namen in einen eindeutigen Hash-Wert umwandeln, um schnelle Suchvorgänge zu ermöglichen. Indexstrukturen wie Bäume oder Hash-Tabellen können verwendet werden, um den Zugriff auf die Namen zu optimieren. Parallelisierungstechniken wie MapReduce können eingesetzt werden, um die Verarbeitung großer Datensätze zu beschleunigen. **
Was sind mögliche Gründe für Nichtübereinstimmungen zwischen verschiedenen Datensätzen?
Mögliche Gründe für Nichtübereinstimmungen zwischen verschiedenen Datensätzen können menschliche Fehler bei der Dateneingabe, unterschiedliche Datenformate oder -strukturen sowie fehlende oder inkorrekte Daten sein. Auch können technische Probleme wie Datenverlust oder -korruption zu Nichtübereinstimmungen führen. Schließlich können auch unterschiedliche Zeitpunkte der Datenerfassung oder -aktualisierung zu Abweichungen zwischen den Datensätzen führen. **


Ähnliche Suchbegriffe für Datensätzen
Top-Angebote
Produkte zum Begriff Datensätzen:
-
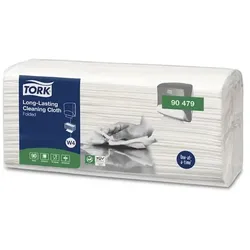
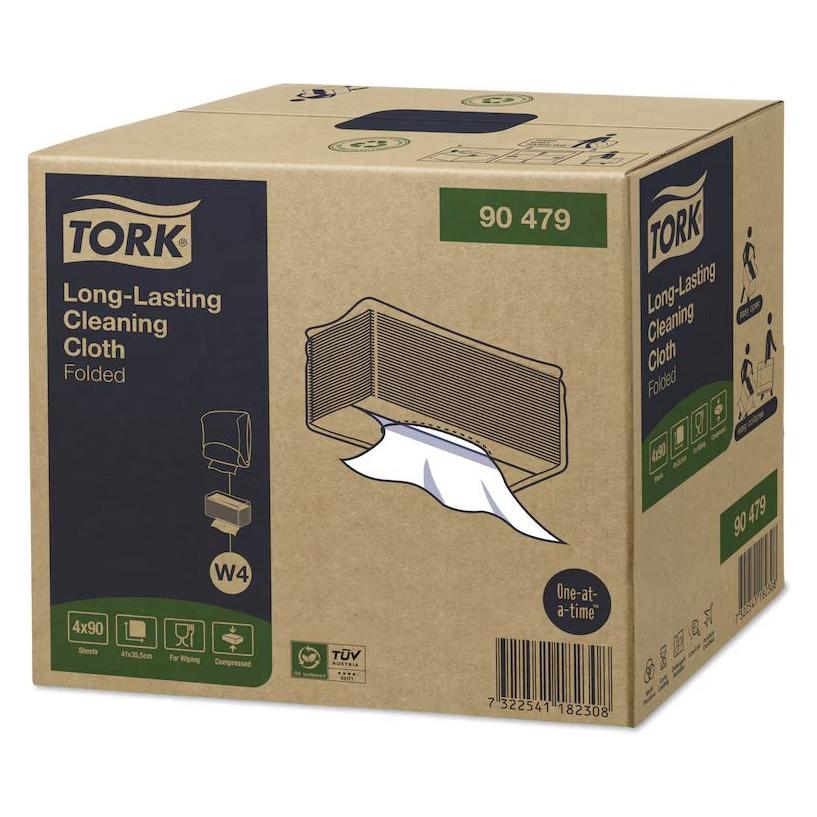
Tork 90479 Wischtuch Langlebiges Reinigungstuch 90 Stück langlebiges Reinigungstuch für W4 EinzeltuchsystemDie Reinigungstücher von Tork sind ausgesprochen saugfähig und besonders strapazierfähig. Sie können mehrmals verwendet werden, ohne zu reißen. Sie passen in den Tork Einzeltuchspender, welcher sie vor Verschmutzungen schützt und jedes Tuch einzeln ausgibt. So wird die Hygiene verbessert und der Verbrauch gesenkt, da man weniger Müll verursacht. Blattbreite: 35,5 cm Blattlänge 41 cm Passend für das Tork W4 Einzeltuch System. Wenn nicht -sofort lieferbar- ist die Lieferzeit 5-10 Tage.41,64 €*Versand: 3,95 €Sichere Weiterleitung zum Anbieter

-
Was ist der Unterschied zwischen komprimierten Daten und komprimierten Datensätzen?
Komprimierte Daten beziehen sich auf einzelne Dateien oder Informationen, die durch einen Komprimierungsalgorithmus verkleinert wurden, um Speicherplatz zu sparen. Komprimierte Datensätze hingegen beziehen sich auf eine Sammlung von Daten, die als Ganzes komprimiert wurden, um Platz zu sparen und die Übertragungseffizienz zu verbessern. Ein komprimierter Datensatz kann aus mehreren komprimierten Dateien oder Datenbeständen bestehen, die zusammengefasst wurden. **
-
Was ist der Unterschied zwischen vielen Datensätzen und vielen Tabellen?
Viele Datensätze bezieht sich auf eine große Menge an einzelnen Einträgen oder Zeilen in einer Tabelle. Viele Tabellen hingegen bezieht sich auf eine große Anzahl an verschiedenen Tabellen, die möglicherweise miteinander verknüpft oder in einer Datenbank organisiert sind. Während viele Datensätze sich auf die Menge der Informationen beziehen, bezieht sich viele Tabellen auf die Struktur und Organisation der Daten. **
-
Wie können Abweichungen in großen Datensätzen erkannt und interpretiert werden?
Abweichungen in großen Datensätzen können durch statistische Analysen wie Ausreißererkennung und Clusteranalyse identifiziert werden. Zudem können Data-Mining-Techniken wie Anomalieerkennung und Mustererkennung eingesetzt werden, um ungewöhnliche Muster oder Trends zu erkennen. Die Interpretation der Abweichungen erfordert in der Regel Fachwissen und Kontextwissen, um die Ursachen und Auswirkungen der Abweichungen zu verstehen. **
-
Was sind die wichtigsten statistischen Verfahren zur Analyse von Datensätzen?
Die wichtigsten statistischen Verfahren zur Analyse von Datensätzen sind deskriptive Statistik, Inferenzstatistik und multivariate Analyse. Deskriptive Statistik beschreibt und visualisiert Daten, Inferenzstatistik zieht Schlussfolgerungen über eine Population basierend auf Stichproben und multivariate Analyse untersucht Beziehungen zwischen mehreren Variablen gleichzeitig. **
Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Kompressionsalgorithmen und die Auswahl relevanter Merkmale. Durch diese Maßnahmen kann die Datenmenge reduziert werden, ohne dabei wichtige Informationen zu verlieren. Dadurch wird die Verarbeitungsgeschwindigkeit verbessert und der Speicherplatzbedarf verringert. **
"Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?"
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Dimensionalitätsreduktionstechniken wie PCA und die Nutzung von Clustering-Algorithmen zur Identifizierung von repräsentativen Datenpunkten. Es ist auch wichtig, Ausreißer zu identifizieren und zu entfernen, um die Qualität der Daten zu verbessern und die Effizienz von Analysen zu steigern. Letztendlich sollten die gewählten Methoden darauf abzielen, die Datenmenge zu reduzieren, ohne dabei wichtige Informationen zu verlieren. **
Top-Angebote
Produkte zum Begriff Datensätzen:
-
BEAUDENS Kineshinex Epoxidharzreiniger – Fleckenentfernung, Reinigung, Reparatur, Kratzerreparatur, Polieren, Oberflächenreinigung Und PflegemittelKineShineX Epoxidharzreiniger – Fleckenentfernung, Reinigung, Reparatur, Kratzerreparatur, Polieren, Oberflächenreinigung und Pflegemittel31,60 €*Versand: 3,00 €Sichere Weiterleitung zum Anbieter
-
BEAUDENS Epoxidharzreiniger Zur Fleckenentfernung, Reinigung, Reparatur, Kratzerbeseitigung, Politur, Oberflächenreinigung Und -pflege, Epoxid-poliersprayEpoxidharzreiniger zur Fleckenentfernung, Reinigung, Reparatur, Kratzerbeseitigung, Politur, Oberflächenreinigung und -pflege, Epoxid-Polierspray31,60 €*Versand: 3,00 €Sichere Weiterleitung zum Anbieter
-
Tork 90479 Wischtuch Langlebiges Reinigungstuch 90 Stück langlebiges Reinigungstuch für W4 EinzeltuchsystemDie Reinigungstücher von Tork sind ausgesprochen saugfähig und besonders strapazierfähig. Sie können mehrmals verwendet werden, ohne zu reißen. Sie passen in den Tork Einzeltuchspender, welcher sie vor Verschmutzungen schützt und jedes Tuch einzeln ausgibt. So wird die Hygiene verbessert und der Verbrauch gesenkt, da man weniger Müll verursacht. Blattbreite: 35,5 cm Blattlänge 41 cm Passend für das Tork W4 Einzeltuch System. Wenn nicht -sofort lieferbar- ist die Lieferzeit 5-10 Tage.41,64 €*Versand: 3,95 €Sichere Weiterleitung zum Anbieter
-
Was sind effiziente Methoden zur Namensauflösung in großen Datensätzen?
Effiziente Methoden zur Namensauflösung in großen Datensätzen sind Hashing-Algorithmen, die den Namen in einen eindeutigen Hash-Wert umwandeln, um schnelle Suchvorgänge zu ermöglichen. Indexstrukturen wie Bäume oder Hash-Tabellen können verwendet werden, um den Zugriff auf die Namen zu optimieren. Parallelisierungstechniken wie MapReduce können eingesetzt werden, um die Verarbeitung großer Datensätze zu beschleunigen. **
-
Was sind mögliche Gründe für Nichtübereinstimmungen zwischen verschiedenen Datensätzen?
Mögliche Gründe für Nichtübereinstimmungen zwischen verschiedenen Datensätzen können menschliche Fehler bei der Dateneingabe, unterschiedliche Datenformate oder -strukturen sowie fehlende oder inkorrekte Daten sein. Auch können technische Probleme wie Datenverlust oder -korruption zu Nichtübereinstimmungen führen. Schließlich können auch unterschiedliche Zeitpunkte der Datenerfassung oder -aktualisierung zu Abweichungen zwischen den Datensätzen führen. **
-
Was ist der Unterschied zwischen komprimierten Daten und komprimierten Datensätzen?
Komprimierte Daten beziehen sich auf einzelne Dateien oder Informationen, die durch einen Komprimierungsalgorithmus verkleinert wurden, um Speicherplatz zu sparen. Komprimierte Datensätze hingegen beziehen sich auf eine Sammlung von Daten, die als Ganzes komprimiert wurden, um Platz zu sparen und die Übertragungseffizienz zu verbessern. Ein komprimierter Datensatz kann aus mehreren komprimierten Dateien oder Datenbeständen bestehen, die zusammengefasst wurden. **
-
Was ist der Unterschied zwischen vielen Datensätzen und vielen Tabellen?
Viele Datensätze bezieht sich auf eine große Menge an einzelnen Einträgen oder Zeilen in einer Tabelle. Viele Tabellen hingegen bezieht sich auf eine große Anzahl an verschiedenen Tabellen, die möglicherweise miteinander verknüpft oder in einer Datenbank organisiert sind. Während viele Datensätze sich auf die Menge der Informationen beziehen, bezieht sich viele Tabellen auf die Struktur und Organisation der Daten. **
Ähnliche Suchbegriffe für Datensätzen
-
Wie können Abweichungen in großen Datensätzen erkannt und interpretiert werden?
Abweichungen in großen Datensätzen können durch statistische Analysen wie Ausreißererkennung und Clusteranalyse identifiziert werden. Zudem können Data-Mining-Techniken wie Anomalieerkennung und Mustererkennung eingesetzt werden, um ungewöhnliche Muster oder Trends zu erkennen. Die Interpretation der Abweichungen erfordert in der Regel Fachwissen und Kontextwissen, um die Ursachen und Auswirkungen der Abweichungen zu verstehen. **
-
Was sind die wichtigsten statistischen Verfahren zur Analyse von Datensätzen?
Die wichtigsten statistischen Verfahren zur Analyse von Datensätzen sind deskriptive Statistik, Inferenzstatistik und multivariate Analyse. Deskriptive Statistik beschreibt und visualisiert Daten, Inferenzstatistik zieht Schlussfolgerungen über eine Population basierend auf Stichproben und multivariate Analyse untersucht Beziehungen zwischen mehreren Variablen gleichzeitig. **
-
Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Kompressionsalgorithmen und die Auswahl relevanter Merkmale. Durch diese Maßnahmen kann die Datenmenge reduziert werden, ohne dabei wichtige Informationen zu verlieren. Dadurch wird die Verarbeitungsgeschwindigkeit verbessert und der Speicherplatzbedarf verringert. **
-
"Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?"
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Dimensionalitätsreduktionstechniken wie PCA und die Nutzung von Clustering-Algorithmen zur Identifizierung von repräsentativen Datenpunkten. Es ist auch wichtig, Ausreißer zu identifizieren und zu entfernen, um die Qualität der Daten zu verbessern und die Effizienz von Analysen zu steigern. Letztendlich sollten die gewählten Methoden darauf abzielen, die Datenmenge zu reduzieren, ohne dabei wichtige Informationen zu verlieren. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.